


データレイクハウスとは、データウェアハウスとデータレイクの機能を統合プラットフォームにまとめ、構造化データと非構造化データの保存を最適化するデータ管理パラダイムです。
一方、データウェアハウスは構造化データの保存手段として長らく利用されてきましたが、ここ数十年でデータ量が爆発的に増加した結果、データレイクには膨大な量の固有データや非構造化データが保存されるようになりました。
大手のデータベースソフトウェア企業やストレージ管理企業が、組織の保有するあらゆるデータを管理するための最新のハイブリッドソリューションを開発し、売り出し始めたのはごく最近のことです。
データパイプラインの進化:ウェアハウスからレイクへ
データレイクハウスの開発は、企業組織やデータセンターが増え続けるさまざまな種類のデータを管理する方法の進化の結果です。
データレイクハウスを理解するには、まず前身であるデータウェアハウスとデータレイクについて知っておく必要があります。
データウェアハウスとは?
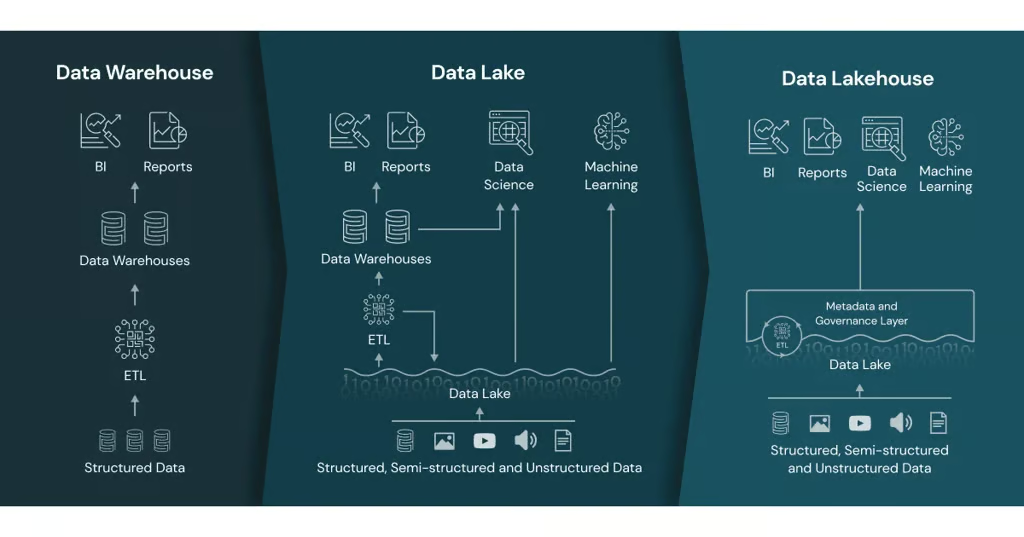
1980年代以降、データウェアハウスは、レポート作成やビジネスインテリジェンス(BI)に使う構造化データを保存するために特化したリポジトリとして利用されてきました。標準的なデータウェアハウスでは、外部データや業務データを抽出、変換、ロード(ETL)ソフトウェアで処理して取り込み、同じデータ形式のリポジトリに構造化データを効率的に変換・保存します。
データレイクとは?
約10年前、PentahoのCTOだったJames Dixonは、データを生の形式で保存するリポジトリを表す言葉として「データレイク」を考案しました。構造化データを保存するデータウェアハウスとは異なり、データレイクには構造化、半構造化、非構造化というあらゆるデータ形式や種類のデータが保存されます。
多くの企業ユースケースで人気が高まっている一方、データレイクはデータサイエンスアプリケーションの検証に適しています。これに対して、データレイク内のその他のデータはETLソリューションを通じてデータウェアハウスやリアルタイムデータベースで利用されます。
比較:主要なデータウェアハウスソリューションとDruidとDremioの比較をTechRepublicでご覧ください。
データウェアハウスとデータレイクの問題
データウェアハウスの問題:硬直的で独自仕様
データウェアハウスは厳格な独自形式に従うため、動画、音声、ストリーミング、さらには人工知能(AI)や機械学習(ML)のようなディープラーニングモデルなど、新しく異なるデータ形式の組み合わせに対応できません。
この非構造化データを管理できないという問題により、企業組織は後にデータレイクとなる大量のデータを抽出して保存するようになりました。
データレイクの問題:無秩序で信頼性が低い
非構造化データの保存には対応するものの、データレイクは信頼性の低いデータスワンプとして知られています。データウェアハウスに期待される効率性と比べると、データレイクは性能が低く、BIアプリケーションのサポートにも苦労しがちです。
データウェアハウスとデータレイクの併用:重複
データレイクが登場して以来、組織は2つの異なるシステムとチームを通じて、ウェアハウスとレイクの両方の機能を活用しようとしてきました。従来型のIT専門家やデータベース管理者がウェアハウスを管理する一方、データサイエンティストはレイクの可能性を引き出すことに注力します。
組織がデータウェアハウスとデータレイクを併存させると、データの重複、プロセスの複製、コストの増加につながることが少なくありません。こうした課題に対処するデータ管理者向けの最新パラダイムが、データレイクハウスです。
詳しく見る:DatabricksがパートナーによるデータおよびAIサービスでのレイクハウスプラットフォーム活用を支援(Channel Insider)。
データレイクハウスとは?
データレイクハウスは、データウェアハウスとデータレイクの両方のコンポーネントを備え、BI、データサイエンス、ディープラーニング、ストリーミング分析に利用できる単一のデータストアを管理者に提供します。データレイクハウスでは、従来のデータウェアハウス管理と同様のインターフェースとデータガバナンスを使って、生データから構造化データ、非構造化データまでを管理できます。
データレイクハウスに一般的に認められている機能には、次のようなものがあります。
- すべてのデータ(構造化、半構造化、非構造化)を単一のリポジトリに保存
- データリポジトリからリアルタイムのインサイトを提供するエンドツーエンドのストリーミング
- 管理者がデータを直接読み書きできるアクセス
- 拡張性と多目的利用を実現するコンピューティングとストレージの分離
- データガバナンスを確立するためのスキーマサポート
- クエリ速度を向上させるインデックス作成とデータコンパクション
- 原子性、一貫性、分離性、永続性(ACID)トランザクションのサポート
複数のシステム、つまりデータウェアハウスとデータレイクをデータレイクハウスに統合することで、組織はスキーマやデータガバナンスの管理を簡素化し、冗長性、複製されたプロセス、オーバーヘッドコストを削減できます。クラウド時代のデータレイクと同様に、データレイクハウスは低コストのストレージと大幅な拡張性を提供します。
主要なデータレイクハウスベンダー
| Cloudera | Couchbase |
|---|---|
| Databricks | DataStax |
| Dremio | IBM |
| Neo4j | Redis |
| Snowflake | TigerGraph |
詳しく見る:IBMがServerWatchの主要データファブリックソリューションに選ばれた理由。
データレイクハウス:両者の長所を兼備
データレイクハウスは、組織内のデータ管理に関わる関係者が協力するための橋渡し役となります。まだ新しい概念ではあるものの、構造化データと非構造化データを管理する統合ソリューションへの期待は高まっています。発展途上の市場では、複数の注目すべきベンダーがデータレイクハウスの機能を拡充しています。
次世代のデータ管理ソリューションが今後どう発展するか、注目していきましょう。
TechRepublicが選ぶ、データレイクハウスについて知っておくべき5つのポイントで、この記事を締めくくります。
関連記事
- Databricks対Snowflake | TechnologyAdvice
- 主要なDataOpsツール | IT Business Edge
- 予測分析に最適なツールとソフトウェア | TechRepublic
- 最適なMLOpsツールとプラットフォーム | IT Business Edge
- CyrusOneとCoreSiteの買収でデータセンター統合が加速 | Channel Insider
- Databricksが8080 Labsを買収 | TechnologyAdvice
- Databricksがデータを数十億ドル規模に変える | InternetNews