


Ein Failover-Cluster ist im Wesentlichen ein redundantes, leistungsoptimiertes Backup-System für digitale Architekturen. Wenn eine Gruppe aus zwei oder mehr unabhängigen Servern so konzipiert ist, dass sie gemeinsam eine robuste Backup-Struktur bereitstellt, Workloads besser verteilt, die Integrität und Zuverlässigkeit von Anwendungen, Systemen oder Diensten gewährleistet sowie Skalierbarkeit und Verfügbarkeit bietet, spricht man von einem Failover-Cluster.
Failover-Cluster werden intensiv von Branchen eingesetzt, die geschäftskritische Anwendungen, Systeme und Dienste betreiben müssen. Hier erfahren Sie, wie diese Technologie funktioniert, welche verschiedenen Failover-Cluster-Typen es gibt, welche Herausforderungen sie mit sich bringen und wie sie praktisch eingesetzt werden.
Failover-Cluster-Typen
Es gibt zwei Haupttypen von Failover-Clustern: Cluster mit hoher Verfügbarkeit (HA) und Cluster mit kontinuierlicher Verfügbarkeit (CA). Daneben gibt es weitere Optionen, insbesondere für hybride Failover-Lösungen, die virtuelle und physische Infrastrukturen kombinieren.
Welcher Failover-Cluster am besten zu Ihrem Unternehmen passt, hängt von mehreren Faktoren ab, darunter Ihre Infrastruktur, Hard- und Software, der Grad der Komplexität Ihres Systems und Ihrer Anwendungen sowie die Frage, wie geschäftskritisch Ihre digitalen Abläufe sind. Außerdem benötigen einige Branchen geringere Latenzen als andere. Schließlich müssen auch Faktoren wie internes Fachpersonal, Budget sowie Anforderungen an Cybersicherheit und Compliance bewertet werden.
Cluster mit hoher Verfügbarkeit
Cluster mit hoher Verfügbarkeit (HA) sind darauf ausgelegt, Ausfallzeiten zu minimieren und dafür zu sorgen, dass Anwendungen und Dienste stets verfügbar sind – selbst wenn ein Server im Cluster ausfällt. HA-Cluster verwenden in der Regel gemeinsam genutzten Speicher und Clusterrollen, um Daten und Workloads auf mehrere Server zu replizieren. Fällt ein Server aus, kann ein anderer Server im Cluster dessen Workload mit minimaler Unterbrechung übernehmen.
Cluster mit kontinuierlicher Verfügbarkeit
Cluster mit kontinuierlicher Verfügbarkeit (CA) sind dagegen darauf ausgelegt, Anwendungen und Dienste ohne Ausfallzeiten bereitzustellen. CA-Cluster verwenden in der Regel eine als synchrone Replikation bezeichnete Technik, um sicherzustellen, dass Daten auf allen Servern im Cluster jederzeit verfügbar sind. Fällt ein Server aus, kann ein anderer Server im Cluster dessen Workload sofort und ohne Unterbrechung für die Benutzer übernehmen.
Synchrone Replikation in CA-Clustern
Bei der synchronen Replikation werden alle Daten auf den primären Server geschrieben. Anschließend wird gewartet, bis der sekundäre Server den Empfang der Daten bestätigt, bevor eine Antwort an den Client zurückgegeben wird. Dadurch ist sichergestellt, dass die Daten auf beiden Knoten verfügbar sind.
Diese Technik wird häufig für Anwendungen und Dienste eingesetzt, die keine Ausfallzeiten vertragen, etwa Finanzhandelssysteme und geschäftskritische Datenbanken. Allerdings kann die synchrone Replikation auch Latenzen verursachen, da der Client auf die Bestätigung der Daten durch den sekundären Server warten muss, bevor er eine Antwort erhält.
Weitere Failover-Cluster-Typen
Neben HA- und CA-Clustern gibt es einige weitere Failover-Cluster-Typen, darunter:
- Stretch-Cluster: Stretch-Cluster erstrecken sich über zwei oder mehr Rechenzentren. Sie verwenden in der Regel synchrone Replikation und verfügen über Hochgeschwindigkeitsverbindungen mit geringer Latenz sowie über ein ausgezeichnetes Zuverlässigkeits- und Wiederherstellungskonzept.
- Geografisch verteilte Cluster: Geografisch verteilte Cluster werden eingesetzt, um Anwendungen, Systeme und Dienste weltweit oder in großen Regionen bereitzustellen. Die Knoten eines geografisch verteilten Clusters sind über mehrere geografische Regionen verteilt. Solche Cluster verwenden typischerweise auch asynchrone Replikation, um Daten über die verschiedenen Regionen hinweg zu replizieren. Zur Verringerung der Latenz und Verbesserung der Leistung können sie Content-Delivery-Networks (CDNs) oder andere Formen des Edge-Computing nutzen.
Hybride Failover-Cluster: Virtuelle Maschinen, physische Rechenzentren sowie private und öffentliche Clouds
Failover-Cluster können auch physische Server mit virtuellen Maschinen (VMs) oder privaten und öffentlichen Cloud-Infrastrukturen kombinieren. Diese hybriden Cluster werden immer beliebter, da VMs und Cloud-Dienste Unternehmen den Zugriff auf Hardware- und Virtualisierungstechnologien ermöglichen, ohne dass die Hardware oder Software vorab gekauft und gewartet werden muss.
Durch die Kombination der höheren Sicherheit physischer On-Premises- oder Private-Cloud-Knoten mit der Flexibilität und Verfügbarkeit von VMs können Unternehmen außerdem hybride Failover-Cluster erstellen, die das Beste aus beiden Welten vereinen.
In der Regel werden das Backend und die kritischen Komponenten des Clusters in physischen Rechenzentren oder auf Private-Cloud-Knoten bereitgestellt, während kundenorientierte oder öffentliche Systeme, Anwendungen und Dienste auf VMs ausgeführt werden.
Eine weitere Möglichkeit zur Bereitstellung hybrider Failover-Cluster besteht darin, einen Hypervisor zu verwenden, um einen virtuellen Cluster auf einer Schicht physischer Server zu erstellen. Dieser Ansatz bietet möglicherweise die größte Flexibilität und Skalierbarkeit, kann aber auch am komplexesten zu implementieren sein.
Wie funktioniert ein Failover-Cluster?
Die Funktionsweise der Failover-Cluster-Technologie hängt von den eingesetzten Failover-Cluster-Typen ab. Es gibt jedoch mehrere zentrale Technologien, die allen gemeinsam sind und erwähnt werden sollten: gemeinsam genutzter Speicher, Clusterrollen, synchrone Replikation, Heartbeat-Überwachung und Quorum-Abstimmungen.
Gemeinsam genutzter Speicher und Clusterrollen
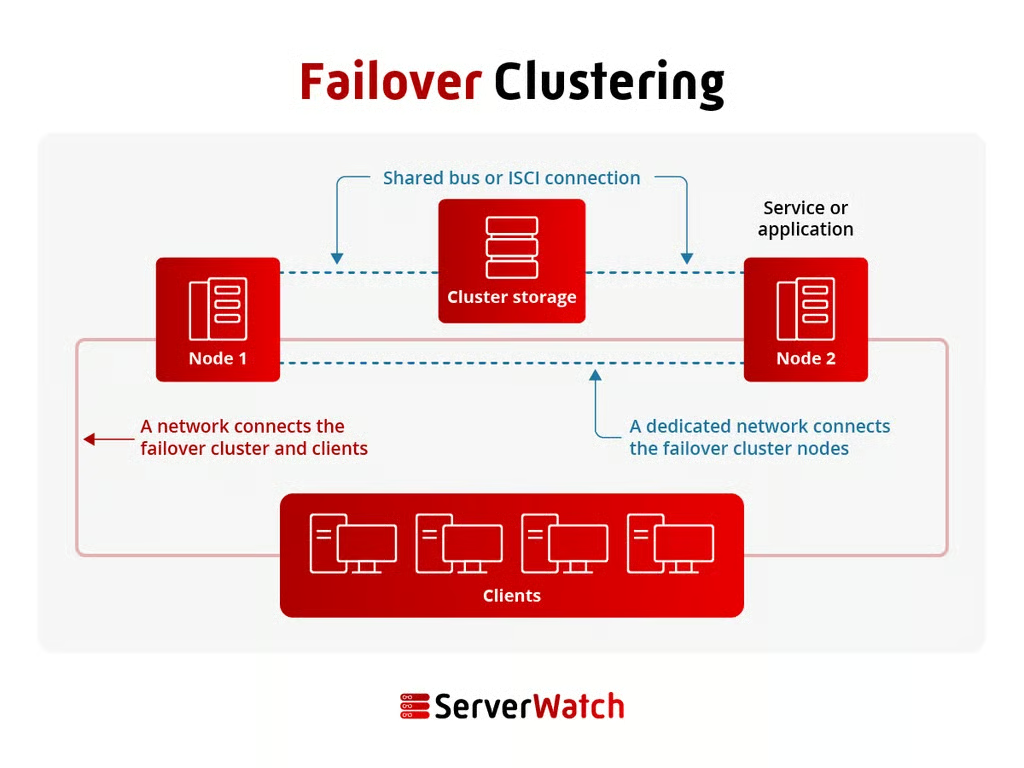
HA-Cluster verwenden in der Regel gemeinsam genutzten Speicher und Clusterrollen, um Daten und Workloads auf mehrere Server zu replizieren.
Zwar verwenden nicht alle Failover-Cluster-Systeme gemeinsam genutzten Speicher, doch bei denjenigen, die dies tun, ist das gemeinsame Speichergerät für alle Server oder Knoten im Cluster zugänglich. Dadurch haben alle Server Zugriff auf dieselben Daten, selbst wenn ein Server ausfällt.
Clusterrollen sind dagegen Anwendungen und Dienste, die von einem Knoten im Cluster auf einen anderen verschoben werden können, ohne die Anwendung oder den Dienst zu unterbrechen.
Heartbeat-Überwachung
Die Heartbeat-Überwachung ist eine Technologie zur Überwachung des Zustands und der Leistung der Knoten. Dabei sendet jeder Knoten im Cluster kontinuierlich über eine dedizierte Netzwerkverbindung einen „Heartbeat“, der seinen Status und seine Verfügbarkeit meldet.
Quorum-Abstimmung
Die Quorum-Abstimmung ist ein Verfahren in Failover-Cluster-Systemen, das sicherstellt, dass stets eine Mehrheit der Server oder Knoten im Cluster betriebsbereit ist.
Bei der Quorum-Abstimmung erhält jeder Server im Cluster eine Stimme. Der Cluster muss über ein Quorum verfügen, also über eine Mindestanzahl an Stimmen, die für seinen Betrieb erforderlich ist.
Die Parameter für die Quorum-Abstimmung können unterschiedlich konfiguriert werden. So kann ein Cluster mit fünf Knoten beispielsweise ein Quorum von vier Knoten erfordern.
Synchrone Replikation
CA-Cluster, die für einen Betrieb ohne Ausfallzeiten konzipiert sind, verwenden in der Regel synchrone Replikation, um sicherzustellen, dass Daten auf allen Servern im Cluster jederzeit verfügbar sind. Auch Stretch-Cluster und geografisch verteilte Cluster verwenden typischerweise synchrone Replikation.
Hybride Cluster können verschiedene Arten von Tools und Technologien verwenden, insbesondere wenn sie mit Diensten und Infrastrukturen führender Virtualisierungsanbieter aufgebaut werden.
Praktische Anwendungen von Failover-Clustern
Sehen wir uns einige praktische, moderne Anwendungen für Failover-Cluster an, die in unserer digitalen Welt häufig zum Einsatz kommen.
Dauerhafte Verfügbarkeit geschäftskritischer Anwendungen
Fehlertolerante Systeme sind für Computer, die in OLTP-Systemen (Online Transaction Processing) eingesetzt werden, unverzichtbar. OLTP, das eine Verfügbarkeit von 100 % erfordert, wird beispielsweise in Flugreservierungssystemen, beim elektronischen Aktienhandel und im Bankbetrieb an Geldautomaten eingesetzt.
Viele andere Organisationen verwenden ebenfalls CA-Cluster oder fehlertolerante Computer für geschäftskritische Anwendungen, etwa Unternehmen aus den Bereichen Fertigung, Logistik und Einzelhandel. Zu den Anwendungen zählen E-Commerce-, Auftragsverwaltungs- und Zeiterfassungssysteme für Mitarbeiter.
Notfallwiederherstellung
Failover-Cluster werden auch für die Notfallwiederherstellung eingesetzt. Fällt ein Rechenzentrum aus, können Anwendungen und Dienste ohne Unterbrechung für die Benutzer auf ein anderes Rechenzentrum umgeschaltet werden. So können Unternehmen sich schnell von einem Notfall erholen und Ausfallzeiten minimieren.
Natürlich ist es dringend ratsam, Failover-Server für den Fall einer regionalen Störung oder Katastrophe wie eines Brandes oder einer Überschwemmung an entfernten Standorten unterzubringen. Durch die Verteilung von Failover-Clustern über mehrere Standorte können Unternehmen Daten zwischen mehreren Rechenzentren replizieren. Tritt an einem Standort eine Katastrophe ein, bleiben sämtliche Daten auf Failover-Servern an anderen Standorten vorhanden.
Daten und Analysen
Die heute in jeder Branche tätige Daten- und Analysebranche hat anspruchsvolle betriebliche Anforderungen, unterliegt häufig strengen Compliance- und Governance-Regeln und muss große Datenmengen verwalten und analysieren. In diesen Umgebungen kommen die Eigenschaften von Failover-Clustern all jenen zugute, die mit dem gesamten Datenlebenszyklus arbeiten.
Edge-Computing
Edge-Computing ist ein Paradigma des verteilten Rechnens, das Berechnungen und Datenspeicherung näher an den Endbenutzer bringt. Failover-Cluster können zur Bereitstellung und Verwaltung von Edge-Computing-Anwendungen und -Diensten eingesetzt werden.
Weitere praktische Einsatzmöglichkeiten von Failover-Clustern sind Webanwendungen, die für die Bewältigung von Verkehrsspitzen hoch skalierbar sein müssen, IoT-Anwendungen (Internet der Dinge), die Edge-Computing erfordern, sowie Branchen wie Fintech, die Echtzeitinformationen mit geringer Latenz verarbeiten, aber ein hohes Maß an Backup und Redundanz benötigen.
Herausforderungen von Failover-Clustern
Trotz ihrer zahlreichen etablierten Vorteile hat die Failover-Cluster-Technologie einige Nachteile. Die bedeutendsten Nachteile stehen mit den erforderlichen Fachkenntnissen und den Kosten in Zusammenhang.
Kosten
Die Kosten von Failover-Clustern können erheblich sein, wenn ein Unternehmen eigene Hard- und Software einsetzen möchte. Glücklicherweise sind mit dem Aufkommen von Cloud Computing und Virtualisierung die Kosten für Hardware, Software sowie Wartung und Verwaltung deutlich gesunken.
Verwaltung
Unternehmen, die anspruchsvolle Failover-Cluster aufbauen möchten, aber nicht über die dafür erforderlichen internen Fachkräfte verfügen, können die Verwaltung der Technologie ebenfalls auslagern. Dies führt zwar zu höheren Kosten, diese liegen jedoch in der Regel deutlich unter den Ausgaben für ein eigenes spezialisiertes Expertenteam.
Doch selbst wenn Unternehmen die Verwaltung und den Betrieb geschäftskritischer Failover-Cluster auslagern, benötigen sie weiterhin mindestens eine kleine Gruppe qualifizierter Mitarbeiter, die sicherstellt, dass die Systeme ordnungsgemäß funktionieren. Dieser Mangel an Fachkräften ist zweifellos das größte Hindernis für diejenigen, die einen Failover-Cluster bereitstellen möchten.
Sicherheit, Compliance und Zuverlässigkeit
Das Fachkräfteproblem wirkt sich außerdem auf Leistung, Sicherheit, Compliance und Datenschutz aus. Ein Failover-Cluster, der nicht ordnungsgemäß aufgebaut, angepasst und konfiguriert ist, birgt ein hohes Risiko für Störungen. Failover-Cluster vergrößern zudem die digitale Angriffsfläche eines Unternehmens und erhöhen damit die Wahrscheinlichkeit, dass Cyberkriminelle eine ausnutzbare Schwachstelle finden.
Die führenden Anbieter von Failover-Clustern
Mehrere Anbieter von Failover-Clustern gelten in der Branche als führende Anbieter.
VMware
Unter den verfügbaren Virtualisierungsprodukten bietet VMware mehrere Virtualisierungstools für VM-Cluster an. vSphere vMotion stellt eine CA-Architektur bereit, die eine VMware-VM und ihr Netzwerk zwischen physischen Rechenzentrumsnetzwerken exakt repliziert.
Microsoft
Microsoft bietet verschiedene Failover-Cluster-Lösungen an, darunter Windows Server Failover Clustering, SQL Server Failover Clustering und Exchange Server Failover Clustering. Die Failover-Cluster-Lösungen von Microsoft werden von Unternehmen jeder Größe häufig eingesetzt und sind für ihre Zuverlässigkeit und Benutzerfreundlichkeit bekannt.
Red Hat Linux Failover Clusters
Auch andere Betriebssystemhersteller bieten eigene Failover-Cluster-Technologien an. Benutzer von Red Hat Enterprise Linux (RHEL) können beispielsweise mit der Red Hat Enterprise Linux High Availability Extension (RHEV) HA-Failover-Cluster erstellen. Die Failover-Cluster-Lösungen von Red Hat sind für ihren Open-Source-Charakter und ihre Flexibilität bekannt. Sie können zum Schutz einer Vielzahl von Anwendungen und Datenbanken eingesetzt und in unterschiedlichen Umgebungen bereitgestellt werden, darunter On-Premises-, Cloud- und hybride Umgebungen.
Oracle
Oracle bietet verschiedene Failover-Cluster-Lösungen an, darunter Real Application Clusters (RAC), Oracle Database Clusterware und Oracle GoldenGate. Die Failover-Cluster-Lösungen von Oracle sind für leistungsstarke und geschäftskritische Anwendungen konzipiert. Sie werden von vielen der weltweit größten Unternehmen eingesetzt, darunter Finanzinstitute, Behörden und Telekommunikationsunternehmen.
Weitere Anbieter von Failover-Clustern
Zu den weiteren beliebten Anbietern und Lösungen für Failover-Cluster im Jahr 2023 gehören IBM PowerHA SystemMirror, NetApp MetroCluster, Rocket iCluster und Veritas InfoScale.
Fazit: Failover-Cluster halten Ihr Unternehmen am Laufen
Von Latenzen und Umgebungen für die Fehlerbehebung über die Konfiguration gemeinsam genutzten Speichers und von Clusterrollen bis hin zur Überwachung von Systemen sind Failover-Cluster schwierig zu implementieren und zu verwalten. Branchenbewährte Verfahren wie der Einsatz zertifizierter Lösungen, Dienste und Hardware sowie die Sicherung von Expertenwissen können helfen, diese Herausforderungen zu bewältigen. Unternehmen sollten außerdem über eine solide Failover-Cluster-Strategie verfügen und ihre Systeme kontinuierlich testen und überwachen, um Leistung und Systemintegrität sicherzustellen.
Trotz dieser Hürden sind Failover-Cluster eine hervorragende Lösung für geschäftskritische Systeme, bieten einen zuverlässigen Schutz für Backup und Wiederherstellung, können die Verfügbarkeit erhöhen und die neueste technologische Innovation vorantreiben.
Schützen Sie Ihre Daten vor Diebstahl, Verlust oder Beschädigung mit einer der besten Server-Backup-Lösungen, die von unseren Experten ausgewählt und geprüft wurden.