


Data Fabrics sind relativ neue Konstrukte. Ihre Ursprünge liegen größtenteils im Datenmanagement, sie sind jedoch auch mit Speicherlösungen, Plattformintegration und anderen Bereichen verknüpft. Sie bieten ein Framework für eine Datenarchitektur, das darauf ausgelegt ist, das Datenmanagement in einer komplexen, vielfältigen und verteilten Umgebung agiler zu machen.
Mehr lesen: Rechenzentrumsumfrage: Ausfälle seltener, aber teurer
Was ist Data Fabric?
Damit Daten als Fabric gelten können, „müssen die Pfade redundant sein und dürfen nicht von einer einzigen Punkt-zu-Punkt-Verbindung abhängen. Wenn also eine Verbindung mit Daten überlastet oder anderweitig nicht verfügbar ist, gibt es andere Wege zum Ziel“, so Datamation, wo Data Fabrics mit dem Aufbau des Internets verglichen werden.
Allerdings ist Data Fabric noch ein sehr junges Gebiet der IT-Landschaft, weshalb Architekturen und Ansätze stark variieren. Viele Data Fabrics nutzen Komponenten wie Metadatenerkennung, Metadatenaktivierung, Datenkatalogisierung, Wissensgraphen für die semantische Modellierung und Orchestrierung.
Hier sind einige Anwendungsbereiche von Data Fabric:
- Quelldaten aus Data Warehouses, Flat Files, XML- oder Webanwendungen können innerhalb der Datenkatalog-/Metadatenebene katalogisiert werden.
- Verbundene Wissensgraphen mit Analysefunktionen können Metadaten innerhalb der Wissensgraphen- und Metadatenanalyseebene aktivieren.
- KI- und Machine-Learning-Algorithmen, die durch aktivierte Metadaten angereichert werden, können dabei helfen, das Design der Datenintegration zu vereinfachen und zu automatisieren.
- Daten können dynamisch für Datennutzer integriert und auf eine Weise bereitgestellt werden, die verschiedene Nutzungsanforderungen erfüllt.
- Datenwissenschaftler, Anwendungsentwickler und BI-Entwickler erhalten saubere und korrekte Daten, sobald sie diese benötigen.
Mehr lesen: Zero-Trust-Sicherheit zum Schutz von Anwendungen und Datenbanken einsetzen
Die besten Data-Fabric-Softwarelösungen
ServerWatch hat zahlreiche Anbieter im Bereich Data Fabric untersucht. Hier sind unsere Favoriten, ohne bestimmte Reihenfolge.
IBM
[missing image]
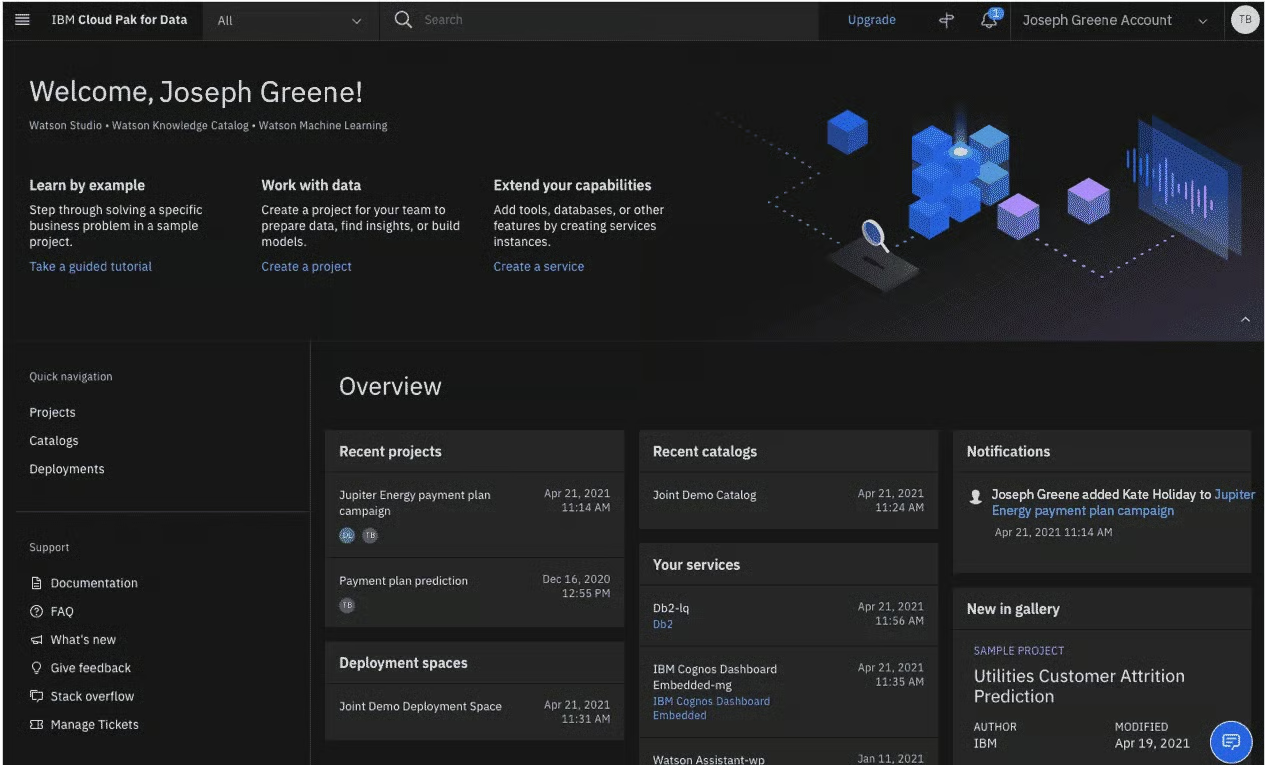
IBM Cloud Pak for Data vereinfacht und automatisiert die Erfassung, Organisation und Analyse von Daten und beschleunigt dadurch den Einsatz von KI im gesamten Unternehmen. Die Lösung kann Daten überall anbinden, Workloads überall ausführen sowie KI in hybriden Cloud-Umgebungen skalierbar entwickeln, bereitstellen und verwalten.
Wichtige Alleinstellungsmerkmale
- KI-basierte Funktionen für Datenmanagement und Data Governance
- Orchestriert und optimiert die Datenverarbeitung auf Grundlage von Workloads, Datenlokalität und Datenrichtlinien
- Der metadatenbasierte Wissenskern erleichtert die Erkennung von Datenquellen und Katalogen, reichert Datenbestände an und führt Analysen zur Gewinnung von Erkenntnissen durch
- Der Wissenskern bietet außerdem eine semantische Suche
- Ermöglicht die Datennutzung durch Extrahieren, Virtualisieren, Transformieren und Streamen von Daten
- Katalogisiert Metadaten, definiert Datenschutzrichtlinien, kuratiert Daten, erfasst die Datenherkunft und übernimmt weitere Aufgaben in den Bereichen Sicherheit und Compliance
- Analysemodelle in verschiedenen Tools können miteinander kommunizieren
TerminusDB
TerminusDB ist eine cloudbasierte, dokumentenorientierte Plattform für das Datenmanagement von Wissensgraphen. Sie verbindet die Leistungsfähigkeit von Wissensgraphen mit der Einfachheit von Dokumenten.
Wichtige Alleinstellungsmerkmale
- Versionierte Datenprodukte erstellen, ausführen, überwachen und teilen, die domänenspezifisch sein und mit anderen Datenprodukten verbunden werden können
- Versionskontrolle, damit Datenteams gleichzeitig am selben Datenbestand zusammenarbeiten können
- Den Wissensgraphen mit Metadaten über Dokumente und Unterdokumente hinweg sowie mit einer vollständigen Commit-Historie katalogisieren
- Der dokumentenorientierte Wissensgraph kann mehrere Analyseendpunkte und operative APIs bereitstellen, um die Wirkung und Effizienz von KI und ML zu maximieren
- Unveränderlicher Datenspeicher mit der Möglichkeit, jeden beliebigen Zeitpunkt innerhalb der Datenhistorie aufzurufen
- Möglichkeit, einen Wissensgraphen aus verknüpften JSON-Dokumenten zu erstellen, um Datenstrukturen und Beziehungen darzustellen
- Daten aus mehreren Quellen übernehmen – vom Data Lake bis zu Flat Files
Talend
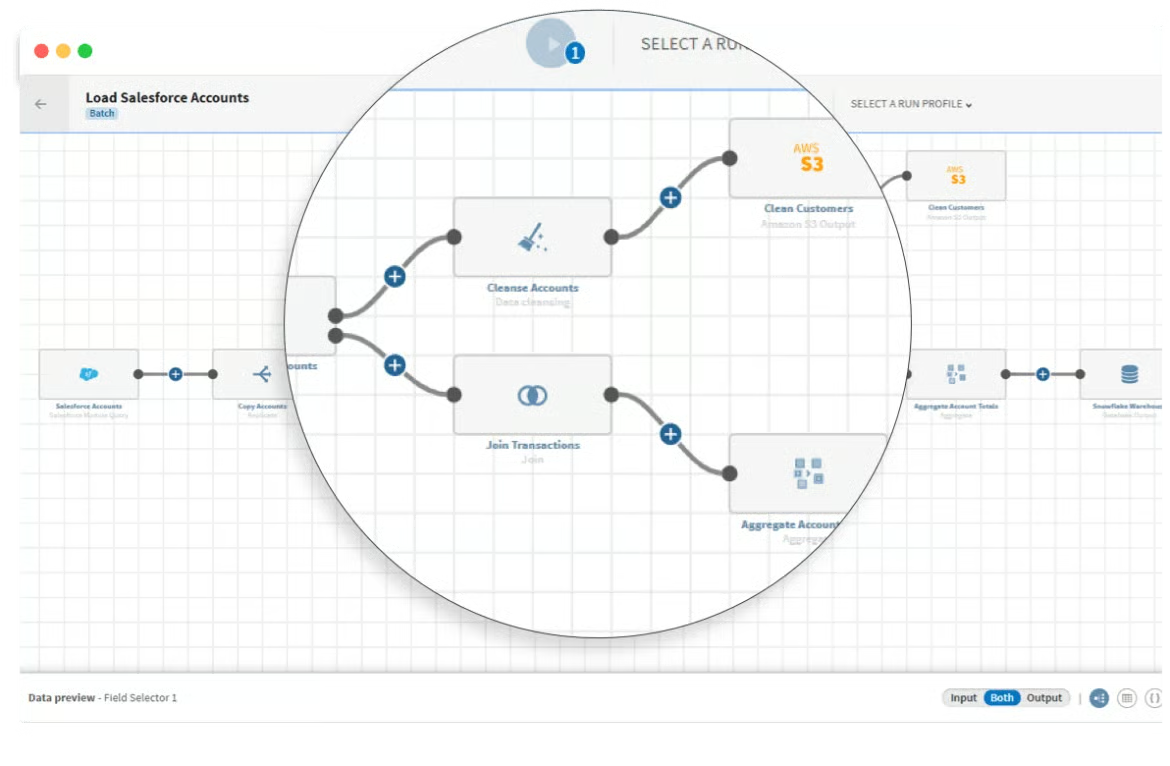
Talend Data Fabric ist eine einheitliche Plattform für Datenaufnahme, Integration, Governance und gemeinsame Nutzung, die den Aufbau eines Daten-Hubs vereinfachen kann. Der Talend Trust Score verstärkt diesen Fokus, indem er auf einen Blick den Zustand Ihrer Daten bewertet – ihre Qualität, Relevanz und Popularität.
Wichtige Alleinstellungsmerkmale
- Mit mehr als 1.000 integrierten Komponenten und Konnektoren können Datensätze erfasst, standardisiert und bereinigt werden
- Techniken zur Datenkatalogisierung erkennen, profilieren, dokumentieren und kategorisieren eingehende Daten automatisch
- Self-Service-Tools nehmen Daten aus nahezu jeder Quelle auf, und integrierte Funktionen zur Datenaufbereitung sorgen dafür, dass die Daten schnell nutzbar sind
- Data Governance wird auf Datenverantwortung, Zertifizierung, Betreuung und Behebung von Problemen angewendet
- Automatisierte Qualitätsprüfungen sowie browserbasierte Point-and-Click-Tools zum Teilen und Erfassen
- Data-Quality-Profile bereinigen und maskieren Daten in Echtzeit
- Machine Learning liefert Empfehlungen zur Behebung von Problemen mit der Datenqualität
- Daten können außerdem mithilfe von Analysen angereichert werden, unter Einsatz von Tools wie Spark, Python, Databricks, RapidMiner und Qubole
- Der Talend Trust Score schafft Transparenz über die Zuverlässigkeit jedes Datensatzes
NetApp
NetApp bietet die Technologien und das Know-how, um eine Data Fabric aufzubauen und eine Strategie an spezifischen Anforderungen und Zielen auszurichten. NetApp schafft mit Visualisierungen und Tools zur automatischen Problembehebung Transparenz über den gesamten Stack.
Wichtige Alleinstellungsmerkmale
- Integrationen bringen die Endpunkte der Data Fabric zusammen, sodass alles über eine einzige Steuerzentrale überwacht und verwaltet werden kann
- Automatisierungen reduzieren die Zahl manueller Aufgaben – von Entwicklung und Tests bis zur Bereitstellung
- Tools optimieren die Infrastruktur kontinuierlich und ermöglichen Skalierung
- Backup- und Wiederherstellungslösungen vereinfachen den durchgängigen Datenschutz bei Ausfällen, Katastrophen oder Ransomware-Angriffen
- KI wird zur Bereitstellung von Sicherheit eingesetzt
- Effiziente Datenübertragungen für cloudbasierte Backups und Wiederherstellungen
- Möglichkeit, Daten problemlos zu und von Hyperscale-Clouds zu verschieben
- Möglichkeit, Silos aufzulösen, indem Daten beim Verschieben von Anwendungen mitfließen
- Eine einheitliche Software-Defined-Architektur, sodass das Datenmanagement über Cloud-Dienste hinweg konsistent bleibt
SAP
Die Enterprise-Data-Fabric-Lösung von SAP besteht aus Funktionen der SAP Business Technology Platform, die von SAP Data Intelligence getragen werden, sowie aus SAP HANA. SAP Data Intelligence ermöglicht die Verwaltung von IoT-Datenströmen, den Aufbau von Data Warehouses und die Operationalisierung skalierbaren Machine Learnings. Die Lösung ermöglicht es Geschäftsanwendungen, sämtliche Unternehmensdaten und Metadaten ganzheitlich und einheitlich zu verwalten, zu integrieren und zu verarbeiten. Sie bietet Self-Service-Funktionen für Datenaufbereitung, aktives Metadatenmanagement und Datenqualität.
Wichtige Alleinstellungsmerkmale
- Spaltenaktionen ausführen, neue Informationen ableiten, unterschiedliche Quellen harmonisieren sowie mehrere Datensätze zusammenführen oder kombinieren
- Ein Datenkatalog identifiziert automatisch Inhalte wie Datentypen oder personenbezogene Informationen und versieht Informationen dieser Inhaltstypen bei der Extraktion der Metadaten mit Tags
- Graph-Engines können zur Identifizierung und Integration verbundener Daten eingesetzt werden
- Attribute wie Namen und Adressen analysieren, standardisieren und validieren; Geocodierung durchführen sowie Duplikate und Beziehungen zwischen Entitäten identifizieren
- SAP HANA kann den Zugriff auf Daten virtualisieren und Abfragen an externe Datenquellen wie andere Datenbanken, Webdienste, Dateien, Apache Hadoop und Apache Spark föderieren, um Abfragen ohne Datenverschiebung durchzuführen
Informatica
Informatica kann jeden Enterprise-Workload mit elastischer und serverloser Verarbeitung skalieren, um bei der Anwendung von KI und ML auf Daten und Metadaten schnell Erkenntnisse zu gewinnen. Im Zentrum steht die KI-Engine CLAIRE, die die Datenlandschaft erlernen kann, um Tausende manueller Aufgaben zu automatisieren und menschliche Tätigkeiten durch Empfehlungen und Erkenntnisse zu erweitern.
Wichtige Alleinstellungsmerkmale
- Kann jede Kombination aus Cloud- und hybriden Infrastrukturen ausführen, integrieren und unterstützen
- Low-Code-/No-Code-Erfahrung mit Funktionen für Sicherheit, Datenqualität, Data Governance und Datenschutz
- Mehr als 200 Datendienste verfügbar
- Leistung durch KI-/ML-gestützte Betriebsüberwachung und prädiktive Erkenntnisse optimieren
- Durchgängiges Cloud-Datenmanagement und eine Microservices-Architektur
Komprise
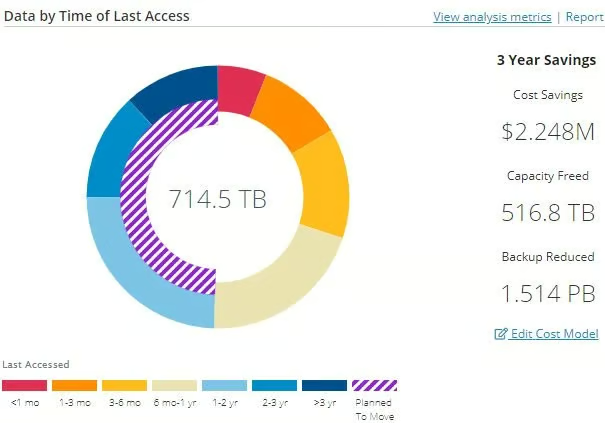
Komprise Intelligent Data Management erstellt einen globalen Metadatenindex, der Speicherressourcen in mehreren Rechenzentren und Clouds analysieren kann. Dadurch können Speicherteams gemeinsam mit den Eigentümern der Daten optimale Datenmanagementrichtlinien festlegen, selten abgerufene Daten in andere Speicherklassen verschieben oder archivieren sowie veraltete Daten migrieren, replizieren oder zur Löschung identifizieren.
Wichtige Alleinstellungsmerkmale
- Kann als SaaS, On-Premises oder hybrid bereitgestellt werden; die Administrationskonsole und der Metadatenindex werden in der Cloud verwaltet, während Datenverschieber in Datennähe bereitgestellt werden
- Transparent Move Technology (TMT) ermöglicht es Komprise, Daten zu verschieben und dabei den transparenten Zugriff für Endnutzer und Anwendungen aufrechtzuerhalten, ohne dass Agents oder proprietäre Stubs installiert werden müssen
- Elastic Grid aus zustandslosen Datenverschiebern (Observers) kann den Dateisystemzugriff auf Daten auch nach dem Verschieben auf sekundäre Speicherziele wie Cloud-Speicher aufrechterhalten
- Deep Analytics Actions machen den manuellen Aufwand überflüssig, benutzerdefinierte Datensätze zu finden und sie getrennt aus verschiedenen Speichersilos zu verschieben
Storage Made Easy
Storage Made Easy Enterprise File Fabric bietet Multi-Cloud-Governance, Compliance und Cybersicherheit. Die Lösung umfasst Speicher-Connectoren und Möglichkeiten zur Stärkung von Remote- und hybriden Speicherumgebungen. Dazu gehört SMBStream, das filerunabhängig und mit NAS-Systemen vor Ort oder Windows-Dateifreigaben kompatibel ist, ebenso wie mit cloudbasierten Server-Message-Block-(SMB-)Freigaben wie Nasuni, Amazon FSx oder Azure Files.
Wichtige Alleinstellungsmerkmale
- Eine File-Fabric-Instanz kann sicher eine Verbindung zu SMB-Freigaben herstellen, ohne sich im selben Netzwerk zu befinden, und so standort- und regionsübergreifende Konnektivität ermöglichen
- Ist angeblich 10-mal schneller als ein herkömmliches VPN und toleriert hohe Latenzen sowie verlorene Pakete
- Die Microsoft-Teams-Integration ermöglicht den Zugriff auf vorhandene Dateifreigaben und andere Speicherdienste wie Amazon S3/FSx und Azure Blob, die direkt in Microsoft Teams eingebettet sind
- Der AutoCAD Previewer ermöglicht es dem Web File Manager, auf Remote-Dateispeichern und in Objektspeichern gespeicherte AutoCAD-Dateien in der Vorschau anzuzeigen
- Data Automation Rules ermöglichen die automatische Transcodierung hochgeladener oder erkannter Dateien sowie den Aufruf benutzerdefinierter Webhooks, wenn Inhalte erkannt werden, die den Kriterien entsprechen
- Secure Link Sharing bietet die Freigabe von Links für namentlich benannte (externe) Benutzer, eine zweistufige Verifizierung der Linkfreigabe und erweiterte Richtlinienkontrollen
- Single-Sign-On-Authentifizierung für Endnutzer bei freigegebenen SMB-Ressourcen
- Vollständige Inhaltssuche in allen mehr als 60 On-Premises- und Cloud-Speicherlösungen
Welche Vorteile bietet eine Data-Fabric-Lösung?
Datenfabrics bieten Unternehmen viele verschiedene Vorteile:
- Sie ermöglichen eine bessere Nutzung der Daten im Unternehmen durch sofortigen Zugriff.
- Datenfabrics sind unabhängig. Sie verknüpfen Daten über viele Plattformen, Architekturen, Prozesse, Anwendungsfälle und geografische Regionen hinweg.
- Sie verbessern die Entscheidungsfindung durch die Bereitstellung geschäftsfertiger Daten für Anwendungen, Analysen und verschiedene Geschäftsprozesse.
- Sie ermöglichen es der IT, Datenmanagement und Data Governance zu vereinfachen , obwohl die Daten in komplexen Umgebungen wie hybriden oder Multi-Cloud-Landschaften vorhanden sind.
- Sie bieten eine einheitliche Sicht auf die Unternehmensdaten, indem sie Daten aus vielen Quellen übernehmen und katalogisieren.
- Da Data Fabric KI und maschinelles Lernen in die Schichten integriert, um den Datenbedarf zu ermitteln, werden die Abfragezeiten verkürzt.
Weiterlesen: Die besten Data-Warehouse-Tools und -Lösungen