


データファブリックは比較的新しい概念です。その起源は主にデータ管理にありますが、ストレージやプラットフォーム統合などの領域にも関わっています。複雑で多様、分散した環境におけるデータ管理をよりアジャイルにするためのデータアーキテクチャフレームワークを提供します。
続きを読む: データセンター調査:障害は減少する一方、コストは増大
データファブリックとは?
ファブリックと呼ぶには、データが「経路に冗長性を備え、単一のポイントツーポイント接続に依存していてはなりません。ある接続がデータで過負荷になったり、何らかの理由で利用できなくなったりしても、宛先までの別の経路が存在する必要があります」と、Datamationは説明しています。同誌は、データファブリックをインターネットの設計になぞらえています。
とはいえ、データファブリックはITの世界ではまだ新興分野であり、アーキテクチャやアプローチは大きく異なります。多くのデータファブリックでは、メタデータの検出、メタデータのアクティベーション、データカタログ化、セマンティックモデリングのためのナレッジグラフ構造の利用、オーケストレーションなどのコンポーネントが使われています。
データファブリックの活用例をいくつか紹介します。
- データウェアハウス、フラットファイル、XML、Webアプリケーションなどのソースデータを、データカタログ/メタデータ層内でカタログ化できます。
- 分析機能と接続されたナレッジグラフにより、ナレッジグラフおよびメタデータ分析層内のメタデータをアクティベートできます。
- アクティベートされたメタデータで強化されたAIおよび機械学習アルゴリズムにより、データ統合設計を簡素化・自動化できます。
- データはデータ利用者向けに動的に統合され、さまざまな利用要件を満たす方法で提供されます。
- データサイエンティスト、アプリケーション開発者、BI開発者は、必要なときにクリーンで正確なデータを取得できます。
続きを読む: アプリケーションとデータベースを保護するゼロトラストセキュリティの活用
主要なデータファブリック・ソフトウェアソリューション
ServerWatchでは、データファブリック分野のさまざまなベンダーを評価しました。以下では、順不同で特に優れた製品を紹介します。
IBM
[missing image]
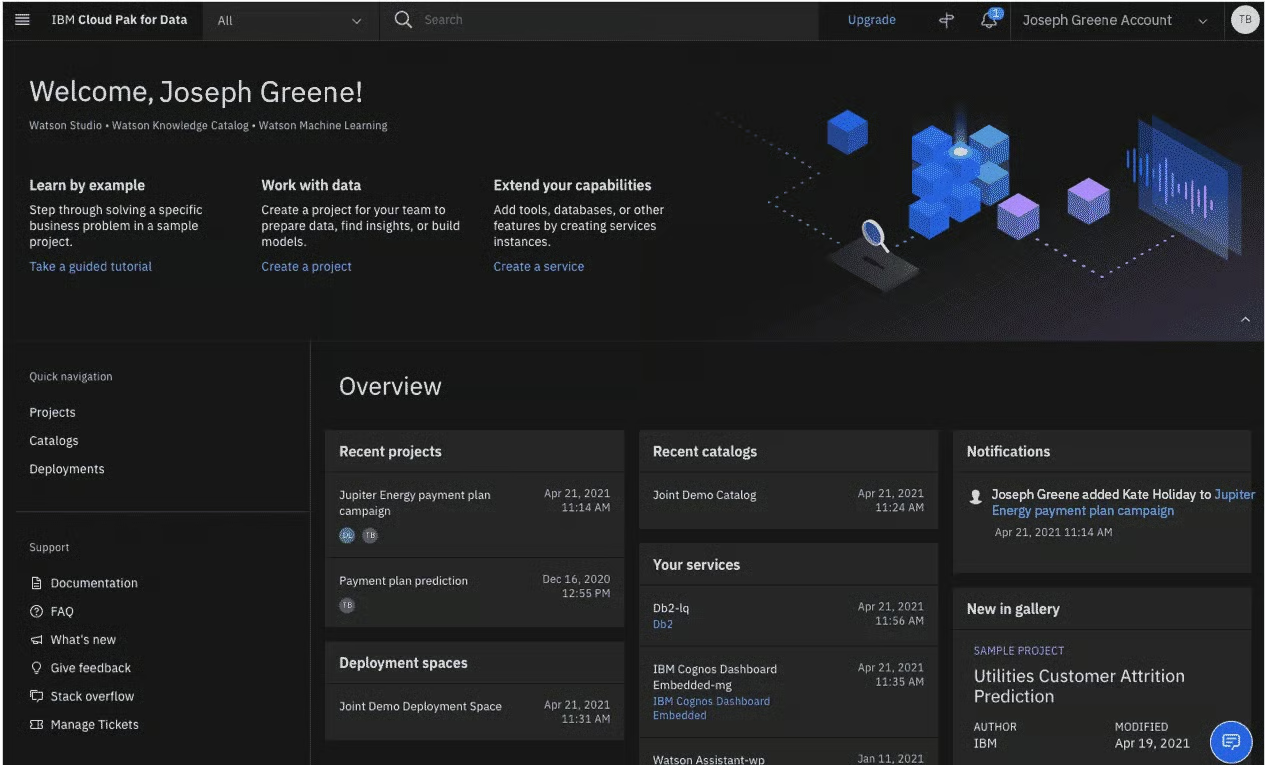
IBM Cloud Pak for Dataは、データの収集、整理、分析を簡素化・自動化し、企業全体へのAI導入を加速します。あらゆる場所のデータを接続し、どこでもワークロードを実行できるほか、ハイブリッドクラウド環境でAIを大規模に構築、導入、管理できます。
主な差別化要因
- AIベースのデータ管理およびガバナンス機能
- ワークロード、データの所在、データポリシーに基づいてデータ処理をオーケストレーションし、最適化
- メタデータベースのナレッジコアにより、データソースとカタログの検出、データ資産の強化、洞察を抽出する分析を実行
- ナレッジコアはセマンティック検索にも対応
- データの抽出、仮想化、変換、ストリーミングによりデータ消費を実現
- メタデータのキュレーション、プライバシーに関するデータポリシーの定義、データのキュレーション、データリネージの取得など、セキュリティとコンプライアンスに関わる各種タスクを実行
- 異なるツールの分析モデル同士を連携可能
TerminusDB
TerminusDBは、クラウドベースのドキュメント指向ナレッジグラフ・データ管理プラットフォームです。ナレッジグラフの強力さと、ドキュメントのシンプルさを組み合わせています。
主な差別化要因
- ドメイン固有で他のデータプロダクトにも接続できる、バージョン管理されたデータプロダクトを構築、実行、監視、共有
- データチームが同じアセット上で同時に協業できるバージョン管理
- ドキュメントとサブドキュメント全体にわたるメタデータ、および完全なコミット履歴によるナレッジグラフのカタログ化
- ドキュメント指向ナレッジグラフに複数の分析エンドポイントと運用APIを備え、AIおよびMLの効果と効率を最大化
- データ履歴内の任意の時点に遡れる、イミュータブルなデータストア
- リンクされたJSONドキュメントのナレッジグラフを構築し、データ構造と関係を表示
- データレイクからフラットファイルまで、複数のソースからデータを取得
Talend
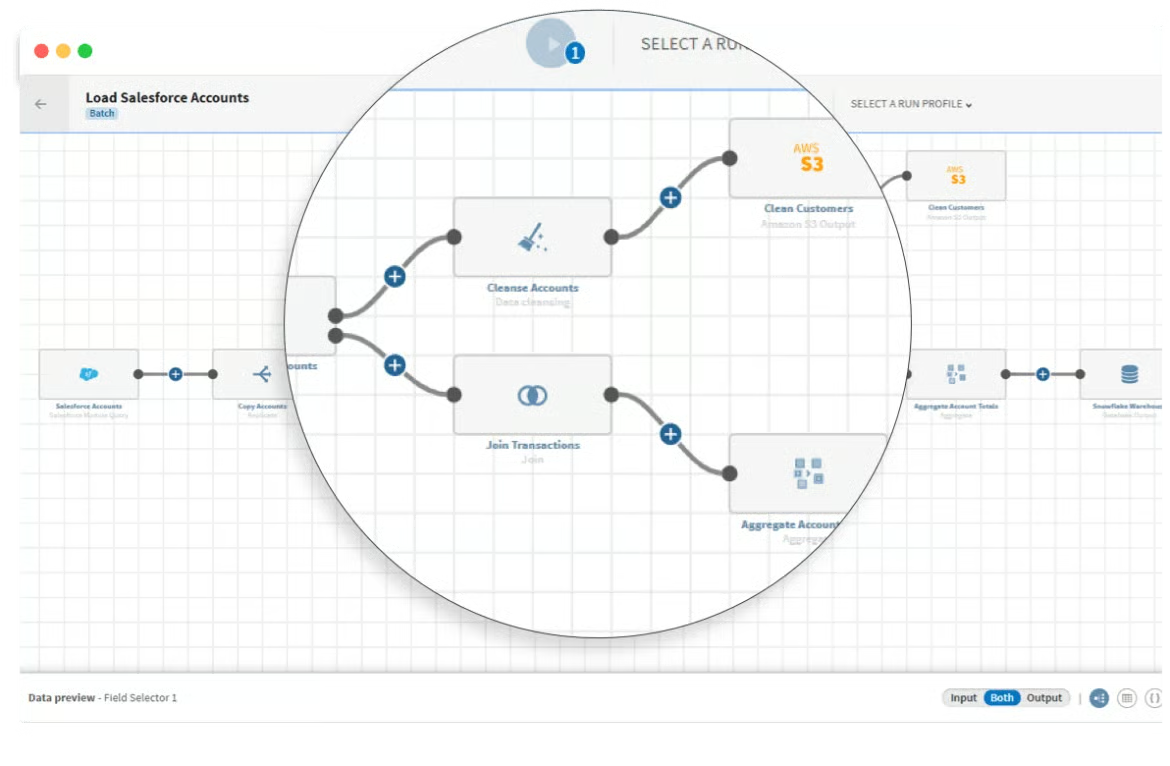
Talend Data Fabricは、データ取り込み、統合、ガバナンス、共有のための統合プラットフォームであり、データハブの構築を簡素化できます。Talend Trust Scoreは、データの健全性、つまり品質、関連性、人気度をひと目で評価できるようにすることで、この取り組みをさらに推進します。
主な差別化要因
- 1,000以上の組み込みコンポーネントとコネクターにより、データセットを取得、標準化、クレンジング
- データカタログ化技術により、取り込まれるデータを検出し、自動的にプロファイリング、文書化、分類
- セルフサービスツールでほぼあらゆるソースからデータを取り込み、統合された準備機能によりデータを迅速に利用可能にする
- データの所有権、認証、スチュワードシップ、修正にデータガバナンスを適用
- 自動品質チェックと、共有・取得のためのブラウザベースのポイント&クリックツール
- Data Qualityにより、リアルタイムでデータのプロファイリング、クレンジング、マスキングを実行
- 機械学習により、データ品質の問題への対処方法を推奨
- Spark、Python、Databricks、RapidMiner、Quboleなどのツールを活用した分析によって、データを強化することも可能
- Talend Trust Scoreにより、任意のデータセットの信頼性を可視化
NetApp
NetAppは、データファブリックを構築し、固有の要件や目標に沿った戦略を策定するためのテクノロジーと専門知識を提供します。可視化機能と、問題を自動的に修正するツールにより、スタック全体を可視化できます。
主な差別化要因
- 統合機能によりデータファブリックのエンドポイントをまとめ、単一のコントロールパネルから全体を監視・管理
- 自動化により、開発・テストからプロビジョニングまでの手作業を削減
- ツールがインフラを継続的に最適化し、スケーリングを可能にする
- バックアップおよびリカバリソリューションにより、障害、災害、ランサムウェア攻撃の発生時にもエンドツーエンドのデータ保護を簡素化
- AIを活用してセキュリティを提供
- クラウドベースのバックアップおよびリカバリに対応した効率的なデータ転送
- ハイパースケールクラウドとの間でデータを容易に移動できる可能性
- アプリケーションの移行に伴ってデータを移動できるようにし、サイロを排除
- 統合されたSoftware Definedアーキテクチャにより、クラウドサービス全体でデータ管理の一貫性を維持
SAP
SAPのエンタープライズデータファブリック・ソリューションは、SAP Business Technology Platformを中核とし、SAP Data IntelligenceおよびSAP HANAで構成されます。SAP Data Intelligenceは、IoTデータストリームの管理、データウェアハウスの作成、スケーラブルな機械学習の運用化を可能にします。ビジネスアプリケーションにより、企業のすべてのデータとメタデータを包括的かつ統一的に管理、統合、処理できます。データ準備、アクティブメタデータ管理、データ品質のためのセルフサービス機能も提供します。
主な差別化要因
- 列に対する操作、新たな情報の導出、異なるソースの調和、複数データセットの統合・結合を実行
- データカタログがデータ型や個人情報などのコンテンツを自動的に識別し、メタデータの抽出時にコンテンツタイプに応じて情報にタグを付与
- グラフエンジンを使用して、接続されたデータを識別・統合
- 氏名や住所などの属性を解析、標準化、検証し、ジオコーディングを実行するとともに、エンティティ間の重複や関係を特定
- SAP HANAはデータへのアクセスを仮想化し、他のデータベース、Webサービス、ファイル、Apache Hadoop、Apache Sparkなどの外部データソースにクエリをフェデレーションできるため、データを移動せずにクエリを実行可能
Informatica
Informaticaは、弾力的でサーバーレスな処理により、あらゆる企業ワークロードをスケールさせ、データとメタデータにAIやMLを適用する際に迅速な洞察を得られるようにします。その中核となるのがCLAIREと呼ばれるAIエンジンです。データ環境を学習して数千件の手作業を自動化し、推奨事項や洞察によって人間の活動を拡張できます。
主な差別化要因
- クラウドおよびハイブリッドインフラのあらゆる組み合わせを実行、相互運用、サポート可能
- セキュリティ、データ品質、データガバナンス、プライバシーを提供するローコード/ノーコード体験
- 200以上のデータサービスを提供
- AI/MLを活用した運用監視と予測インサイトによりパフォーマンスを最適化
- エンドツーエンドのクラウドデータ管理とマイクロサービスアーキテクチャ
Komprise
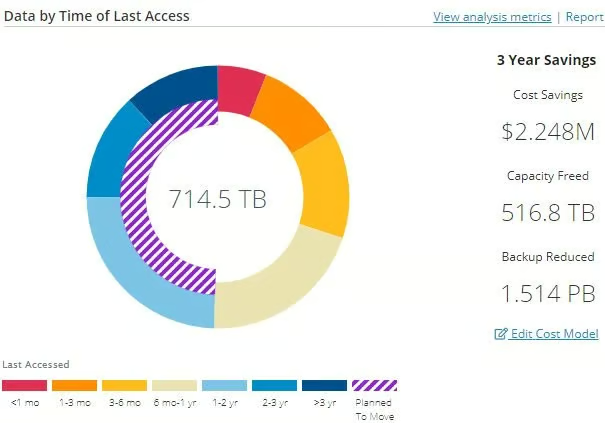
Komprise Intelligent Data Managementは、複数のデータセンターやクラウドのストレージリソースを分析できるグローバルメタデータインデックスを作成します。ストレージチームがデータ所有者と協力して最適なデータ管理ポリシーを決定し、アクセス頻度の低いデータを階層化またはアーカイブできるほか、データを移行、複製したり、不要なデータを特定して削除したりできます。
主な差別化要因
- SaaS、オンプレミス、ハイブリッドとして導入可能。管理コンソールとメタデータインデックスはクラウドで維持され、データムーバーはデータに隣接して配置される
- Transparent Move Technology(TMT)により、エージェントや独自スタブをインストールせず、エンドユーザーとアプリケーションの透過的なアクセスを維持しながらKompriseでデータを移動可能
- ステートレスなデータムーバー(Observer)で構成されるElastic Gridにより、クラウドストレージなどの二次ストレージターゲットへ移動した後も、データへのファイルシステムアクセスを維持可能
- Deep Analytics Actionsにより、カスタムデータセットを見つけ、異なるストレージサイロから個別に移動する手作業を排除
Storage Made Easy
Storage Made Easy Enterprise File Fabricは、マルチクラウドのガバナンス、コンプライアンス、サイバーセキュリティを提供します。ストレージコネクターと、リモートおよびハイブリッドストレージ環境を強化する方法を備えています。これには、ファイラーに依存せず、オンプレミスのNASやWindowsファイル共有に対応するSMBStreamに加え、Nasuni、Amazon FSx、Azure FilesなどのクラウドベースのServer Message Block(SMB)共有も含まれます。
主な差別化要因
- File Fabricインスタンスは、同じネットワーク上に併置されていないSMB共有にも安全に接続でき、サイト間およびリージョン間の接続を実現
- 一般的なVPNより10倍高速とされ、高いレイテンシーやパケットのドロップにも耐性を持つ
- Microsoft Teamsとの統合により、Amazon S3/FSxやAzure Blobなどの既存のファイル共有やその他のストレージサービスにアクセスでき、Microsoft Teams内に直接組み込んで利用可能
- AutoCAD Previewerにより、Web File Managerはリモートファイルストレージやオブジェクトストレージに保存されたAutoCADファイルをプレビューできます
- Data Automation Rulesにより、アップロードまたは検出されたファイルの自動トランスコードや、条件に合致するコンテンツが検出された際のユーザー提供Webフックの呼び出しが可能になります
- Secure Link Sharingは、名前付き(外部)ユーザーへのリンク共有、リンク共有時の2段階認証、ポリシー制御の強化を提供します
- エンドユーザー向けのSMB共有リソースへのシングルサインオン認証
- オンプレミスおよびクラウド上の60以上のストレージソリューションを対象とした、コンテンツ全体の検索
データファブリック・ソリューションのメリットとは?
データファブリックは、企業にさまざまなメリットをもたらします。
- 即時アクセスを提供することで、企業内でデータをより有効活用できるようにします。
- データファブリックは非依存型です。複数のプラットフォーム、アーキテクチャ、プロセス、用途、地域にまたがるデータを結び付けます。
- アプリケーション、分析、各種ビジネスプロセス向けにビジネスで利用可能なデータを提供することで、意思決定を改善します。
- IT部門がデータ管理とガバナンスを簡素化できるようにし、ハイブリッド環境やマルチクラウド環境などの複雑な環境にデータが存在する場合でも対応できます。
- 組織データの単一ビューを提供し、多くのソースからデータを取り込み、カタログ化します。
- データファブリックには、データのニーズを判断するためのAIと機械学習が各層に組み込まれているため、クエリ時間が短縮されます。
続きを読む: 最適なデータウェアハウスツールとソリューション